


AI議事録の怖さは「もっともらしい誤り」にある
「AIに要約させた議事録に、ある決定事項が書かれていた。ところが録音を聞き直すと、誰もそんな発言をしていなかった。」
最近、SNSではこのようなAI議事録に関する体験談が相次いで話題になりました。過去数ヵ月分のAI議事録を見直したところ、多くの箇所に実際には話されていない内容が含まれていた、という報告も寄せられています。
AI出力の信頼性については、異なる分野においても報告されています。
- 学術分野:ChatGPTに84本の短い文献レビューを書かせ、636件の引用を調べた研究では、実在しない引用文献の割合がGPT-3.5で55%、GPT-4で18%でした(2023年当時のモデル)。
- 法務分野:外部の文書を検索して回答に使う仕組み(RAG)を採用した法律専門の調査ツールでも、回答の17〜33%に虚偽の内容や誤った根拠づけが見つかっています。
これは特定のサービスだけの問題ではありません。複数のAIモデルを同じ条件で比べた研究でも、モデルによって差はあるものの、誤りがゼロのモデルは一つもありませんでした。Google、OpenAI、Anthropicといった主要なAI企業も、公式資料でこの問題を認めています。
しかも注意したいのは、明らかにおかしい誤変換ではありません。文章としては自然に読めてしまう誤りです。議事録は、後から意思決定や監査、契約の根拠として見返されます。だからこそ、「読みやすさ」よりも「実際の発言に忠実であること」が大切です。
議事録で起こる誤りのパターン
AI議事録の誤りは、生成AIのハルシネーションだけが原因ではありません。録音から記録が確定するまでの各工程で、種類の違うエラーが起こります。代表的なパターンを見ていきましょう。
※以下は実際の事故例ではなく、研究や検証で確認されている失敗のパターンをもとに作成した架空のサンプルです。
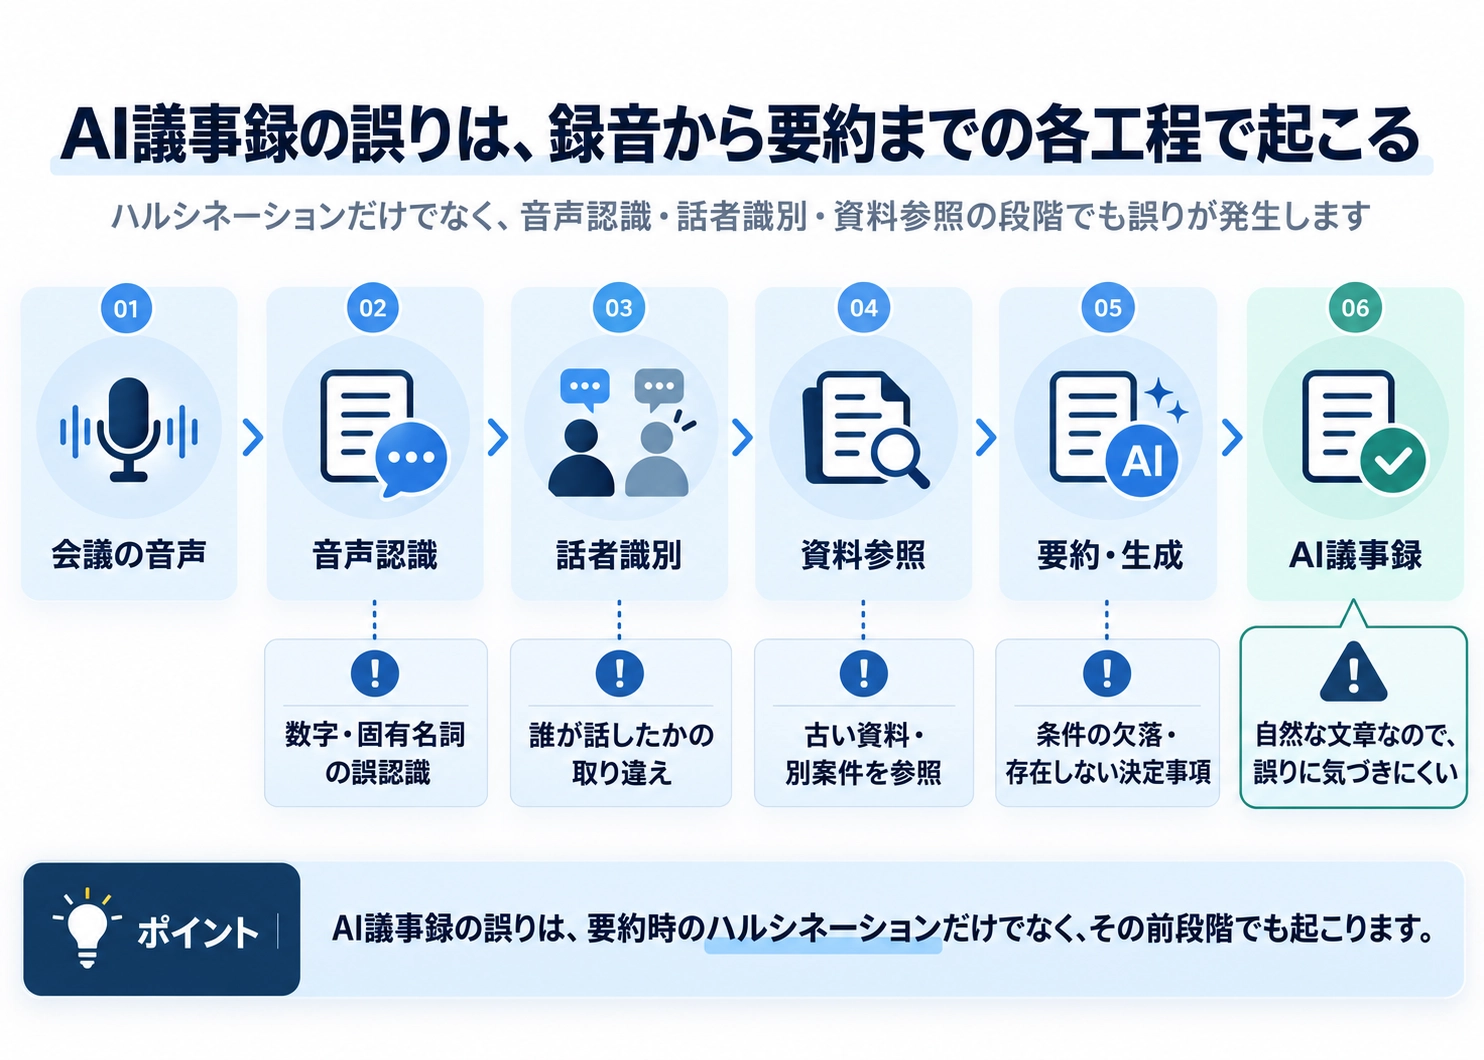
パターン① 存在しない決定事項が加わる
| 実際の発言 | 「来月まで継続して検討しましょう」 |
|---|---|
| 要約結果 | 「来月から実施することを決定した」 |
誤りの種類:要約時のハルシネーション
会議では出ていなかった承認・結論・担当者・期限を、要約の段階で書き加えてしまうケースです。取締役会などでこのような誤りが起こると、承認されていない案件が実行に移りかねません。
パターン② センシティブな類音語が意味を変える
| 実際の発言 | 「あの会社 特有の硬派な方針ですね」 |
|---|---|
| 音声認識結果 | 「あの会社 特定の宗派の方針ですね」 |
| 要約結果 | 「先方企業の宗教的な方針について言及があった」 |
誤りの種類:音声認識の誤変換 → 要約で増幅
日本語の音声認識の研究では、「換金→監禁」「師匠→死傷」のように、音は近いものの意味が大きく変わる誤変換が報告されています。
要約AIがその文字起こしを正しい情報であると判断して整理すると、誤認識された情報が自然な文章として議事録に残ってしまいます。特に数字、日付、会社名、人名などは、わずかな違いでも実務への影響が大きいため注意が必要です。
パターン③ 条件付き合意が無条件の承認になる
| 実際の発言 | 「法務部の確認が完了した場合に限り進めます。ただ、私は現時点では反対です」 |
|---|---|
| 要約結果 | 「進めることで合意した」 |
誤りの種類:発言や条件の欠落
要約では文章を短くするため、情報の一部が省略されます。この結果、条件や反対意見が抜け落ちてしまうと、意思決定の内容そのものが変わってしまいます。
パターン④ 発言者が入れ替わる
| 実際の発言 | 社外監査役「この計画には法的リスクがあります」 |
|---|---|
| 要約結果 | 社長「この計画には法的リスクがあります」 |
誤りの種類:話者の誤帰属
参加者が多い会議や、発言が重なる場面で起こりやすい誤りです。発言内容が同じでも、誰の発言かによって、賛否や責任の所在が大きく変わります。
パターン⑤ 別の資料の数字が紛れ込む
| 実際の発言 | 「予算は次回までに再試算します」 |
|---|---|
| 要約結果 | 「予算は500万円で確定」(過去の別案件の資料の数字) |
誤りの種類:参照情報の取得ミス
過去の議事録や社内資料を検索して回答に利用する仕組みでは、古い版や別案件の資料を参照することがあります。外部資料を検索して回答に利用するRAGと呼ばれる仕組みを使っていても、適切な資料が取得されるとは限りません。
なぜAI議事録では誤りが起こるのか
音声認識は「もっとも確からしい文字列」を推定する
音声認識システムは、入力された音声と確率を組み合わせて、もっとも確からしい文字列を推定します。従って、雑音、早口、専門用語、固有名詞、発話の重なりが多い場合は、正しく認識するための手がかりが減り、類似した別の言葉として認識されることがあります。
生成AIは、与えられた情報を基に「続き」を作る
人は聞き取れない音声を「今はまだ分からない」と判断し、後から音声と照合することができます。しかしAIは、「決定事項と担当者をまとめてください」と指示された場合、元の会議では明確な決定がなされていなくても、実際にはない結論をもっともらしくまとめてしまうことがあります。
長い会議の場合、「一度に扱える量」の上限が問題となる
生成AIには一度に読み込める情報量に上限(コンテキストウィンドウ)があります。この上限は「トークン」というAI独自の単位で表されます。
例えばGoogleの公式ヘルプ(2026年9月時点)によると、Geminiアプリの上限は次のとおりです。ただしこの数値は、一度に扱える情報量の違いであり、ハルシネーションの少なさや回答精度を直接示す数字ではありません。
| プラン | 一度に扱える上限 | 利用上限 |
|---|---|---|
| AIプランなし(無料) | 32,000トークン | 標準 |
| Google AI Plus | 128,000トークン | 標準の2倍 |
| Google AI Pro | 100万トークン | 標準の4倍 |
| Google AI Ultra | 100万トークン | さらに高い上限 |
Googleは、上限を超えると内容の一部が考慮されなかったり、複数のファイルにまたがる細かい点が抜けた回答になったりする可能性があると説明しています。何ヵ月分もの議事録をまとめて要約させると、古い会議や途中の議論が反映されないまま、それらしい要約ができあがることがあるのです。
また、上限以内であっても、長い文章の途中にある情報をうまく利用できないことがある「lost in the middle」と呼ばれる現象が研究で報告されています。一方、長い議事録を分割して処理すれば、条件と結論、質問と回答、発言者と発言内容などが別々のまとまりに分かれ、関係を正しく把握できなくなる可能性があります。
大切なのは、料金プランや入力上限だけで判断するのではなく、「どの会議の、どの範囲をAIに処理させたのか」を把握できる運用にすることです。
なぜ完成した議事録を読むだけでは不十分なのか
AI議事録の難しいところは、完成した文章を読むだけでは誤りを見抜けないことです。
現在の生成AIは、非常に自然で読みやすい文章を作ります。「日本語として自然」で「よくまとまっている」文章だからこそ、人は「きっと正しいだろう」と思い込みがちです。米国国立標準技術研究所(NIST)も、生成AIがもっともらしい誤情報を作るリスクと、人がAIを過度に信頼してしまうリスクの双方を指摘しています。
発言者は正しいか、その結論は本当に出たのか、条件が削られていないか。こうした点は、元の音声や文字起こしに戻らなければ確認できません。さらに、誤った議事録が一度「正式な記録」として残ると、その後の会議や資料作成、AIによる過去議事録の参照などで、誤情報が繰り返し利用される可能性もあります。
AI議事録の事故を減らすための実務対策
すべての会議を最初から最後まで人が確認するのは、現実的ではない場合もあります。そこで重要になるのが、リスクの高い箇所を重点的に確認できる運用体制です。
- 元の音声を確認できる状態にする:必要な期間、社内規程や機密情報・個人情報の取り扱いルールに従って録音を保管し、確認が必要になったときに一次情報へ戻れるようにします。
- タイムスタンプと話者情報を残す:問題の箇所へすぐ戻り、誰が何を話したのかを確認できるようにします。
- 決定事項・担当者・期限を根拠の発言と結び付ける:重要な項目については、元の文字起こしや発言時刻まで追えるようにします。
- 数字・日付・固有名詞・否定・条件・話者を重点的に確認する:すべてを均等に確認するのではなく、意味への影響が大きい情報を優先します。
- AIに入力した範囲を把握する:対象の会議が抜けていないか、古い資料や別案件のデータが混ざっていないかを確認します。
- 文字起こしと要約を別の工程にする:元の文字起こしと要約を分けることで、どの段階で内容が変わったのかを確認しやすくなります。
- AIの出力は「下書き」として扱う:人による確認が終わるまでは「議事録案」「要約案」とし、そのまま正式記録として確定しない運用にします。
東京反訳の『推測で埋めない記録づくり』
取締役会、株主総会、学術調査、行政の会議など、正確さが求められる記録では、文字起こしの品質そのものが問われます。東京反訳は人の手で文字起こしを行う会社です。主に次の3点を重視して作業しています。
発言していない内容は書かない :「言いたかったと思われる内容」ではなく、「実際に話された内容」を記録します。聞き取れない箇所を推測で補わない :文脈の確認、音声の再確認、関連情報の調査を行います。それでも確定できない箇所は、推測で埋めず、不確定であることが分かる形で原稿に反映します。固有名詞は調べて確認する :企業名、人名、専門用語は音だけで判断せず、公式情報と照らし合わせて表記を確認します。
AIの性能が向上しても、重要な記録では、「分からないものを、無理に分かったことにしない」慎重さが欠かせません。
AIを否定せず、用途で使い分ける
AIは、個人のメモ、会議内容の検索、振り返り、議事録作成の下書きなどで大きな力を発揮します。一方、契約、監査、人事、法務、学術研究、公的な記録など、誤りが大きな影響を持つ場面では、読みやすさや作業速度だけでなく、記録の正確性や検証可能性が求められます。
大切なのは、「AIを使うか、使わないか」だけで考えないことです。
- 「どの用途に使うのか」
- 「どの程度の誤りまで許容できるのか」
- 「間違った場合に元の情報へ戻れるのか」
こうした点を踏まえて、AIと人による確認を使い分ける必要があります。
効率化と、記録の信頼性は同じものではありません。
会議記録や文字起こしの品質についてお悩みの方は、ぜひ東京反訳へご相談ください。
参考資料
- Google「Gemini アプリの利用上限とアップグレード」ヘルプ(2026年9月時点)
- Tamber, M. S. et al. “Benchmarking LLM Faithfulness in RAG with Evolving Leaderboards”(EMNLP 2025 Industry Track)
- Walters, W. H. & Wilder, E. I. “Fabrication and errors in the bibliographic citations generated by ChatGPT”(Scientific Reports, 2023)
- Magesh, V. et al. “Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools”(Stanford University)
- Liu, N. F. et al. “Lost in the Middle: How Language Models Use Long Contexts”
- NIST “Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile”(NIST AI 600-1)
公開日:2026.9.29
